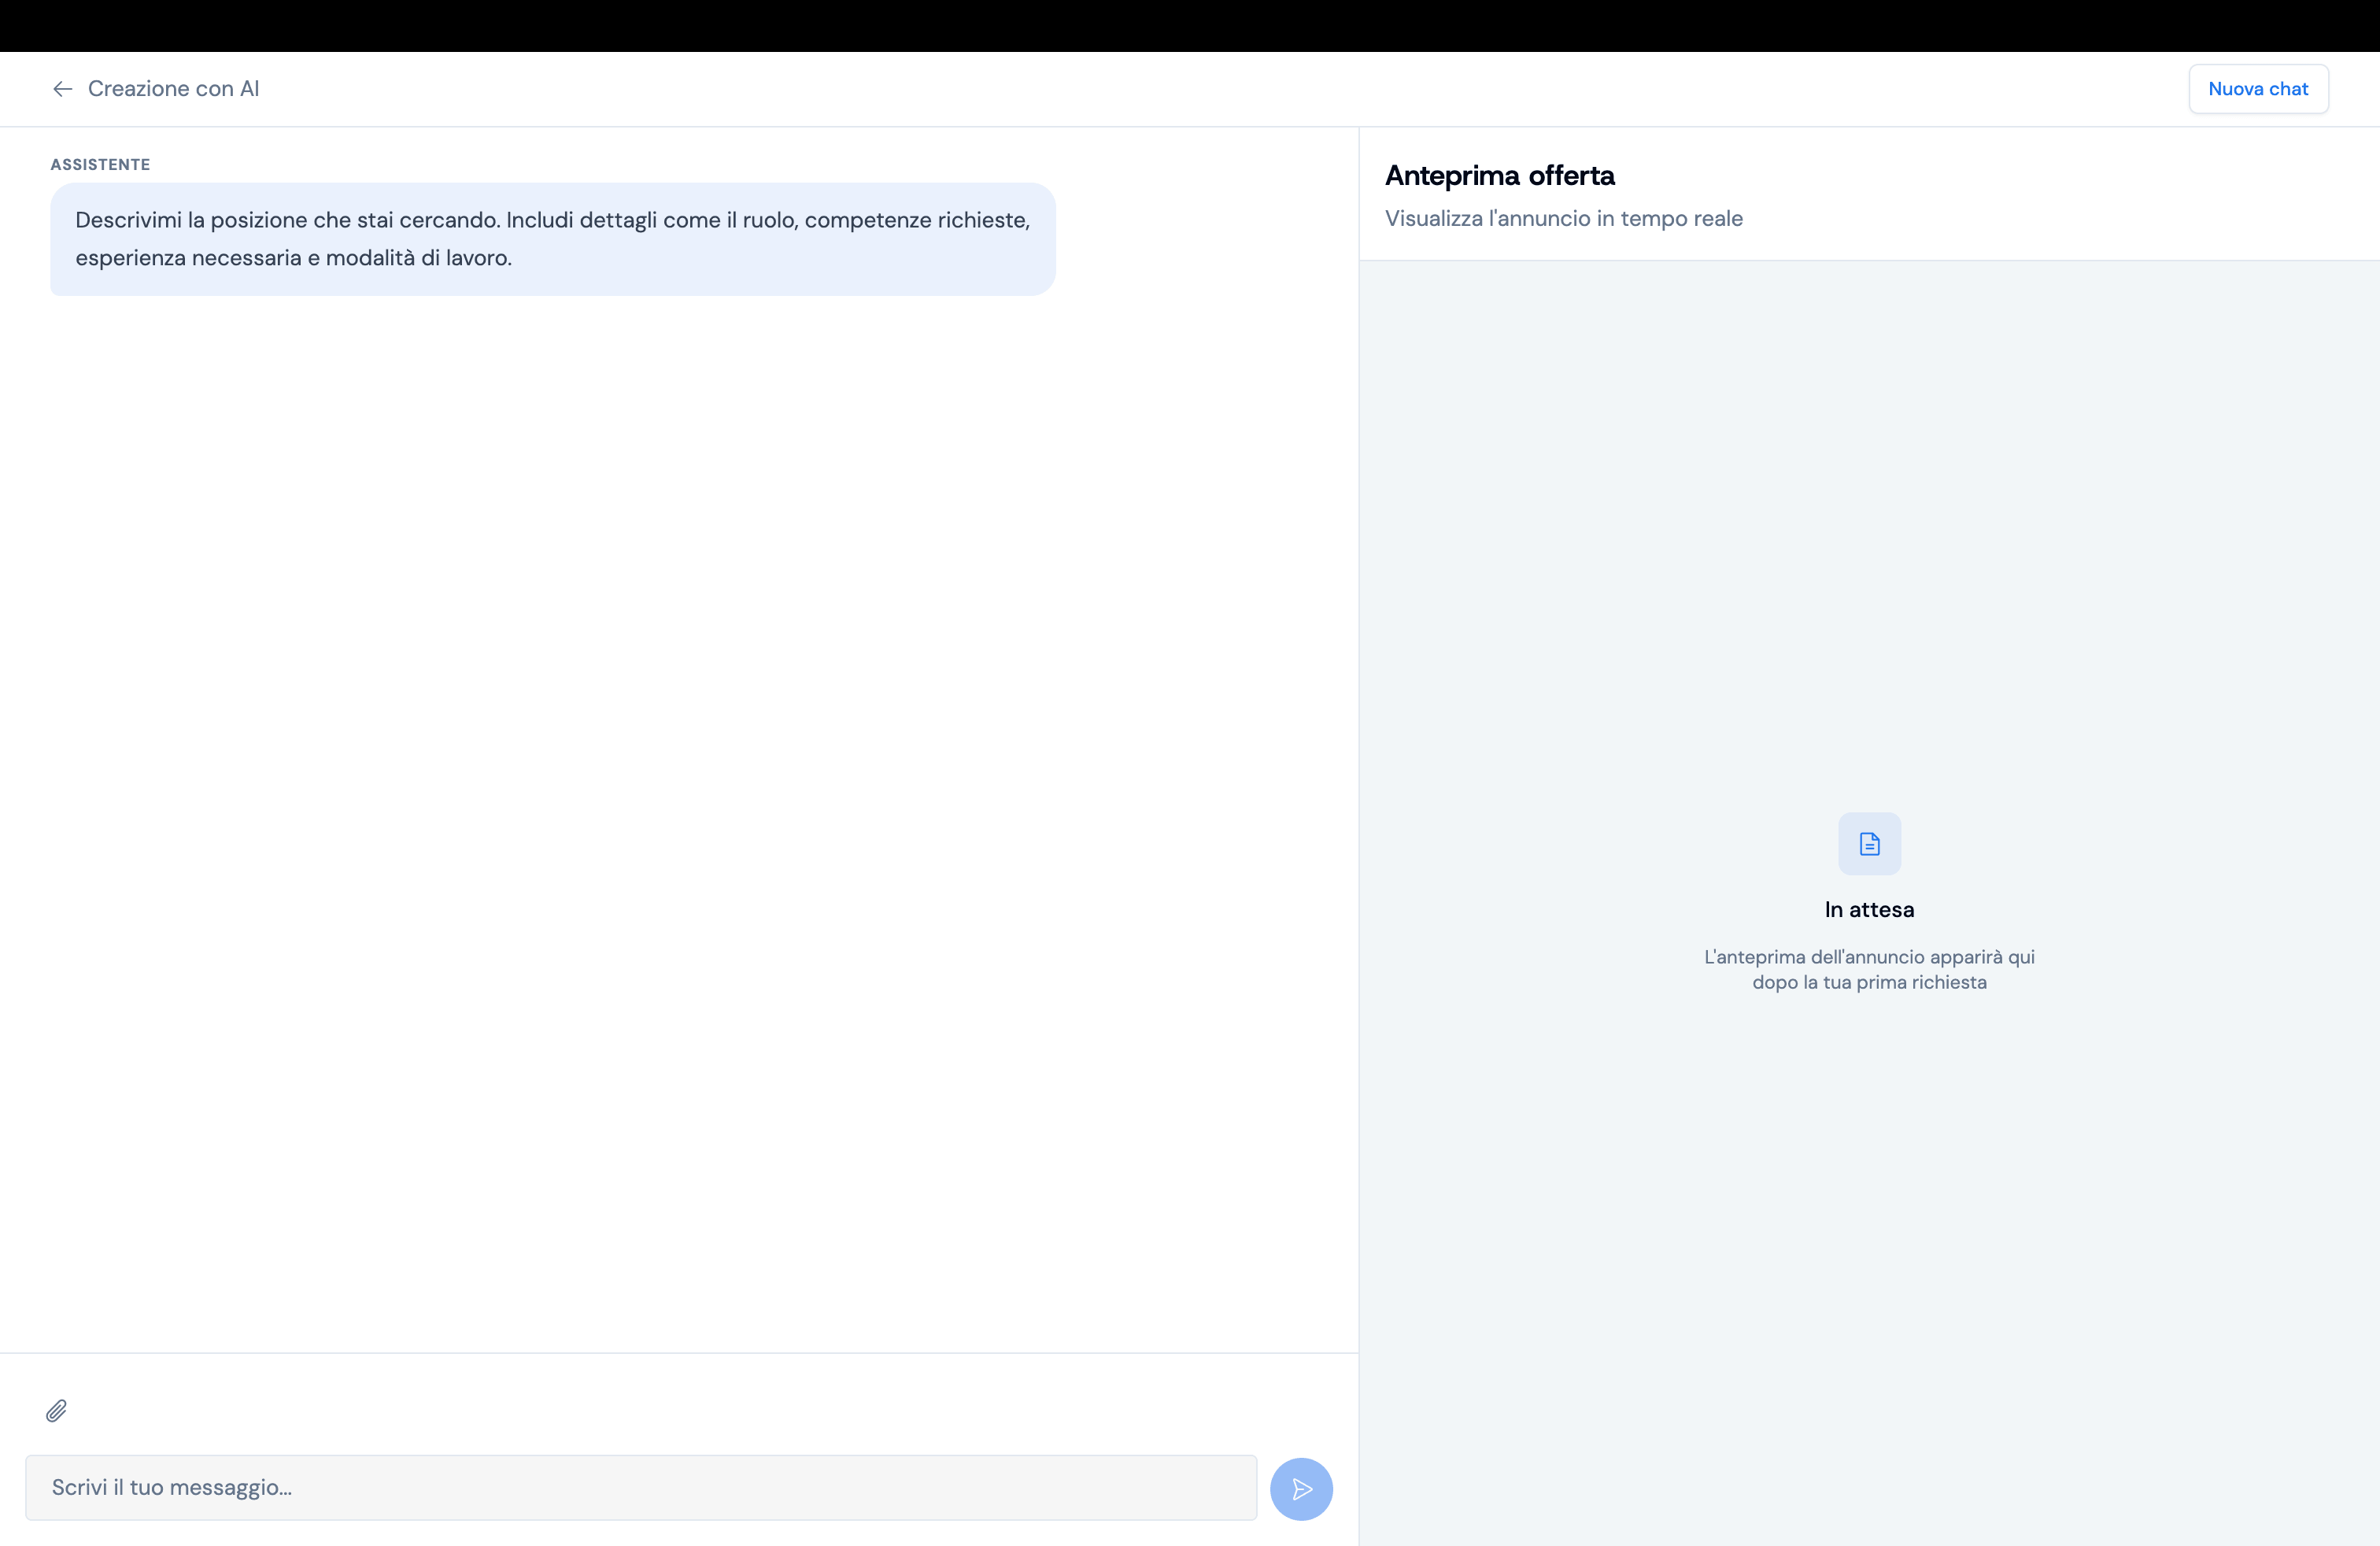
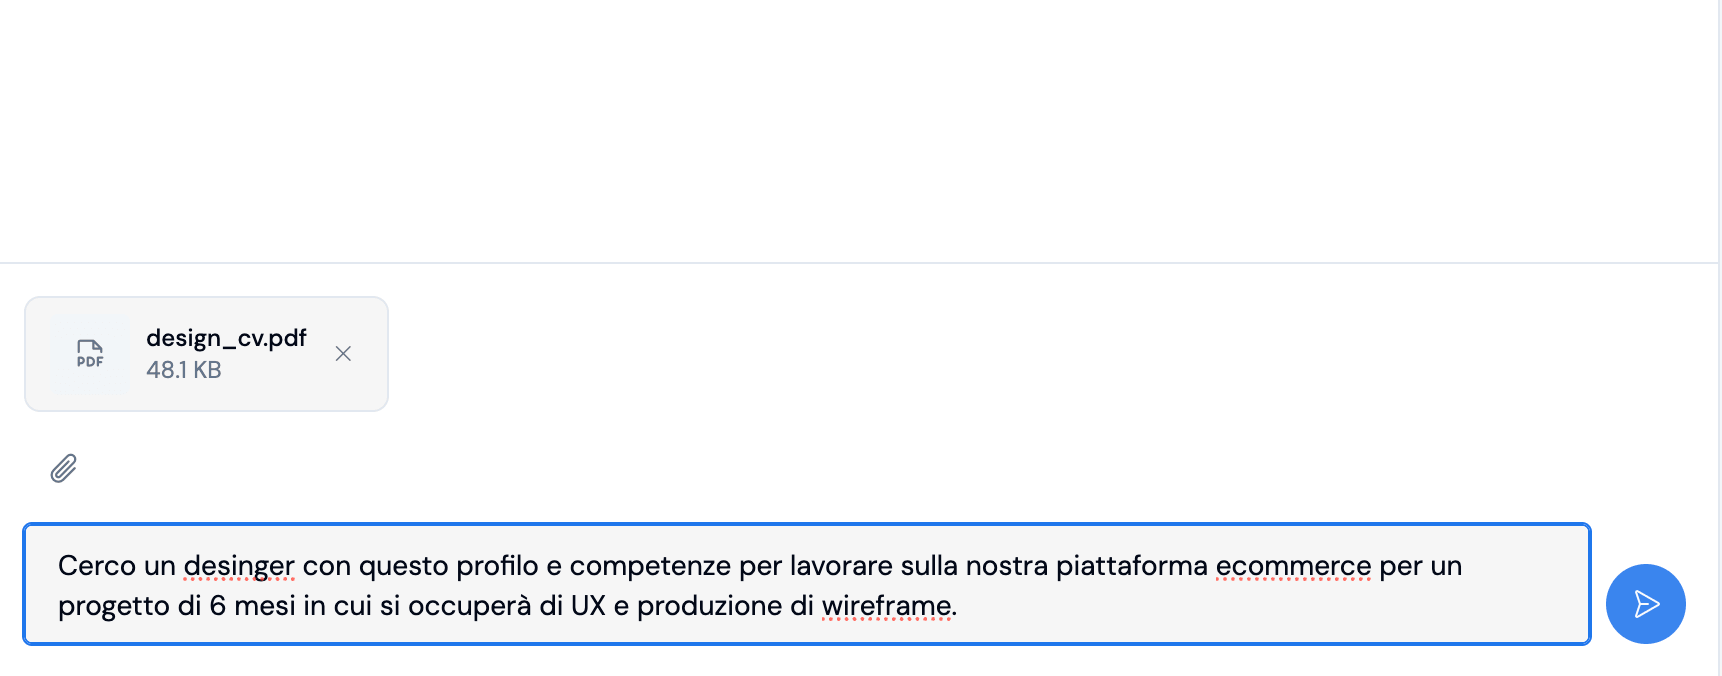
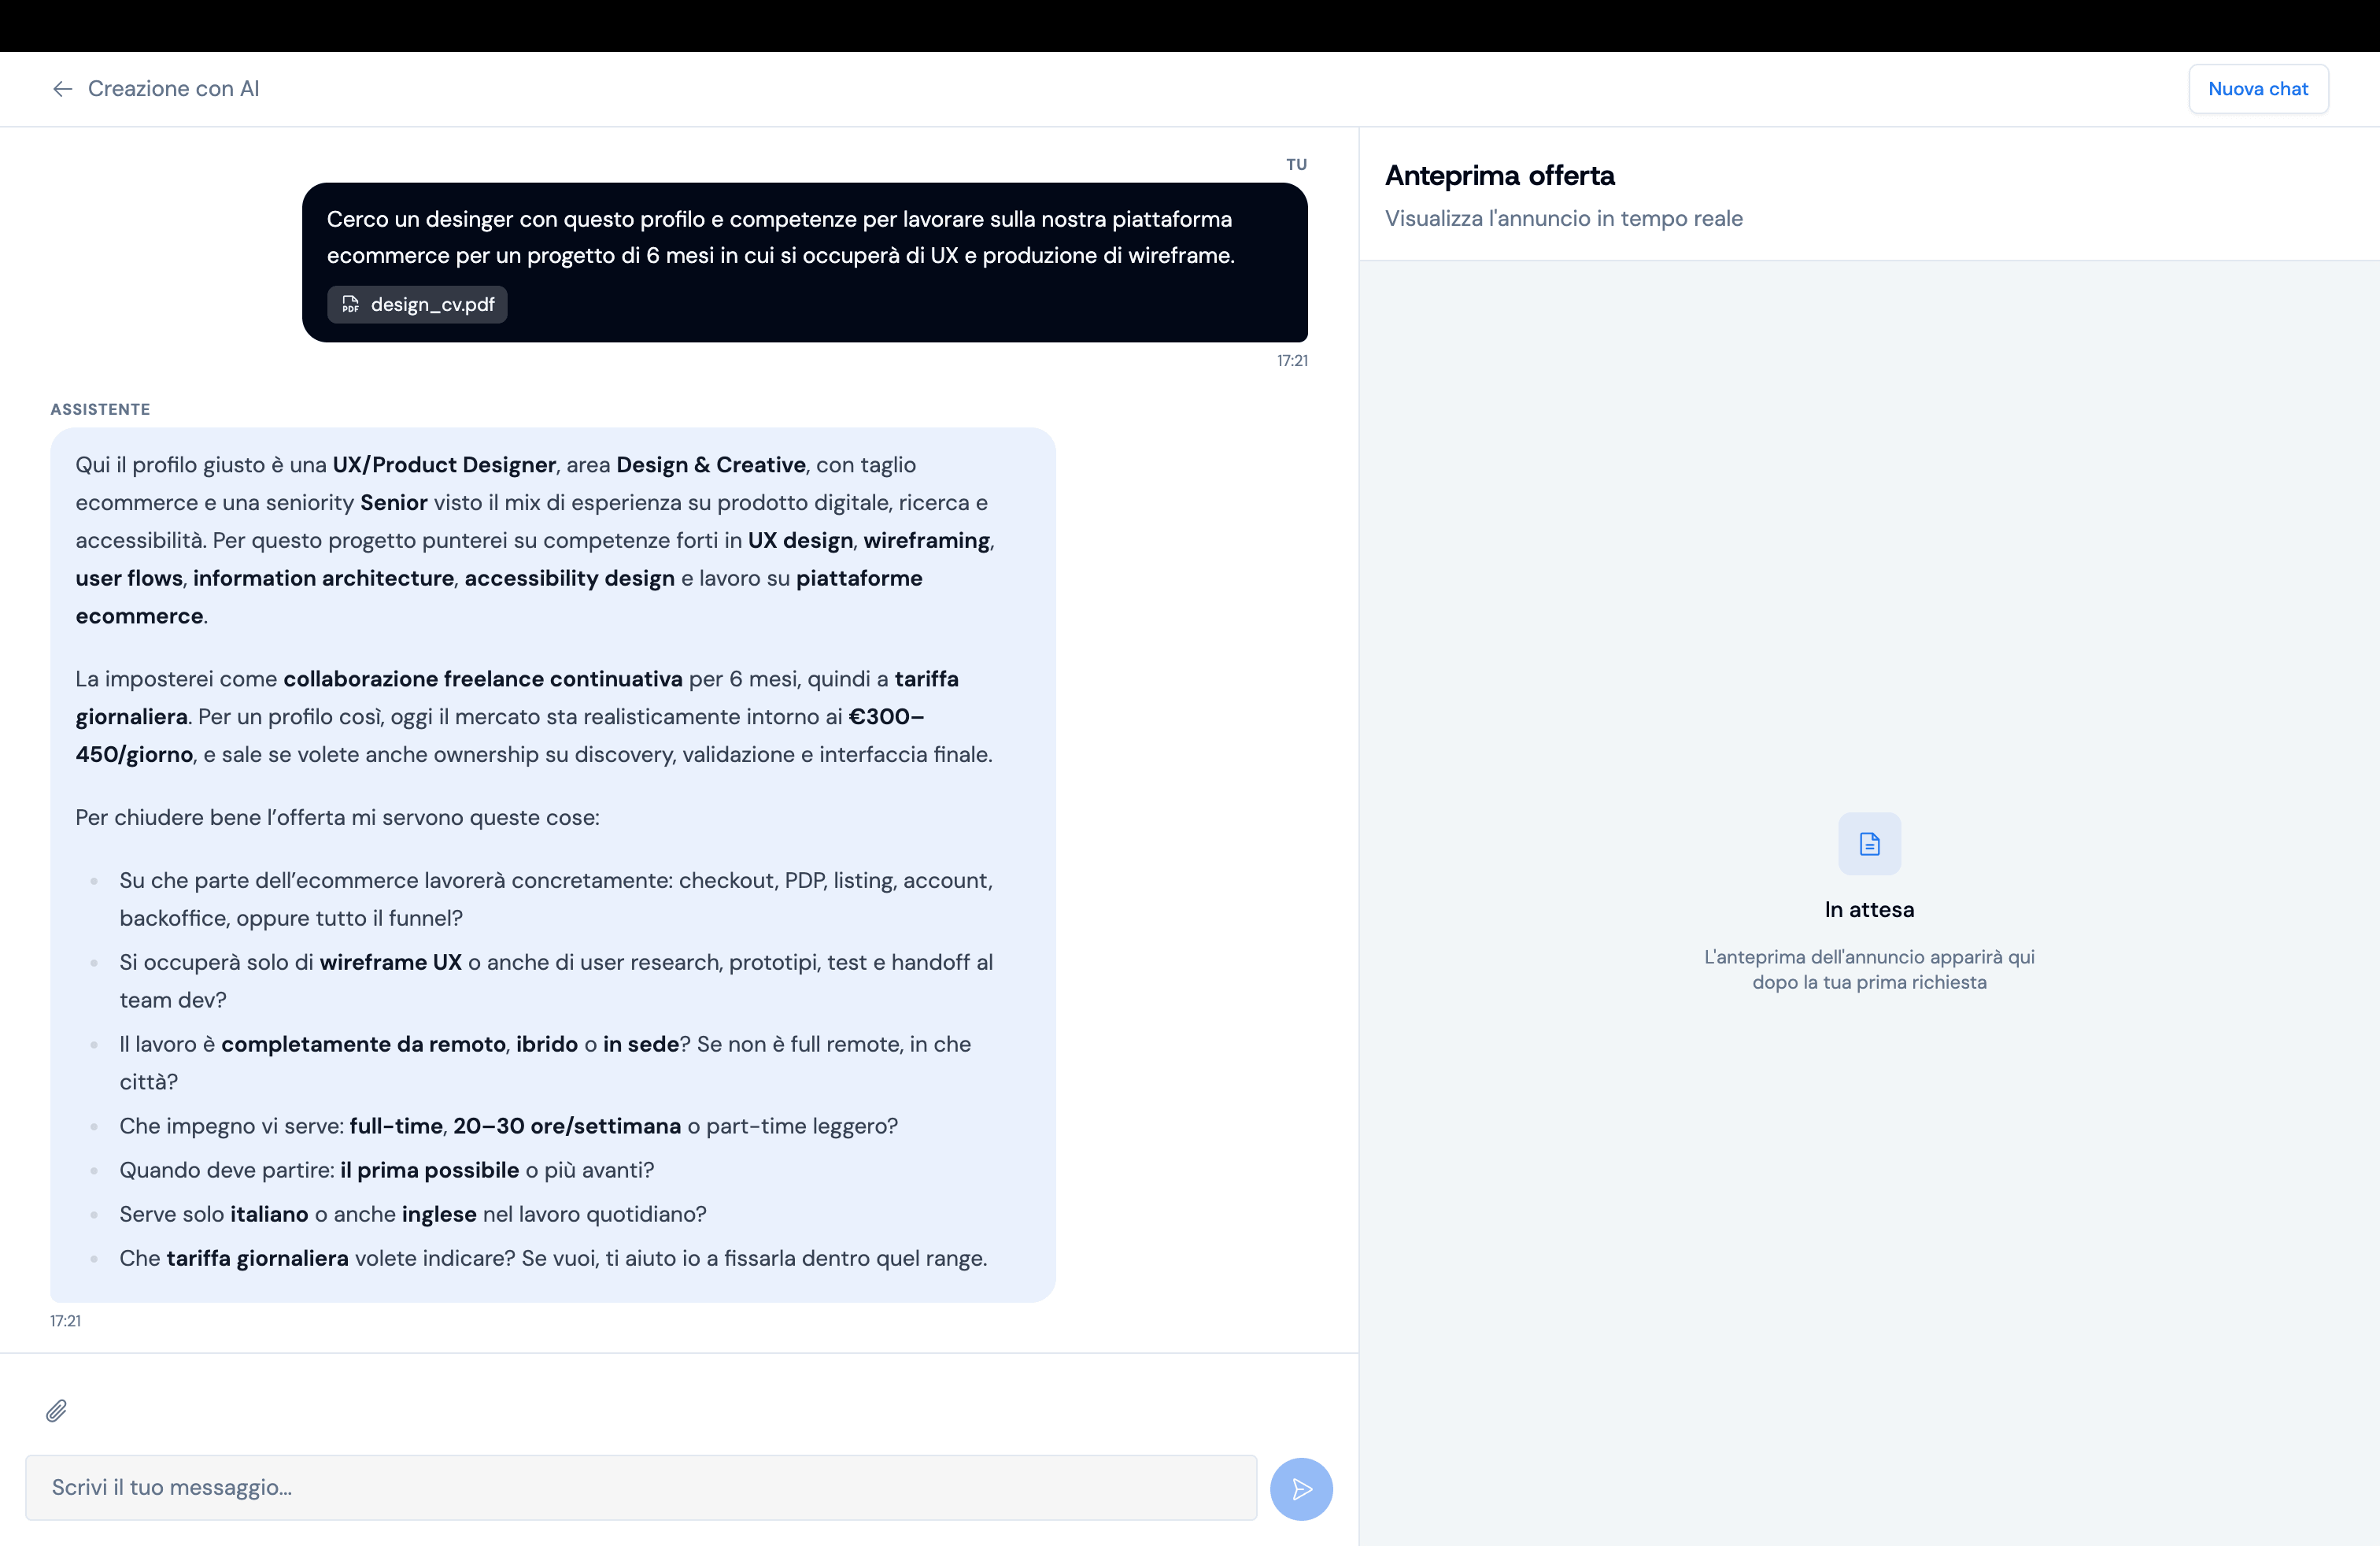
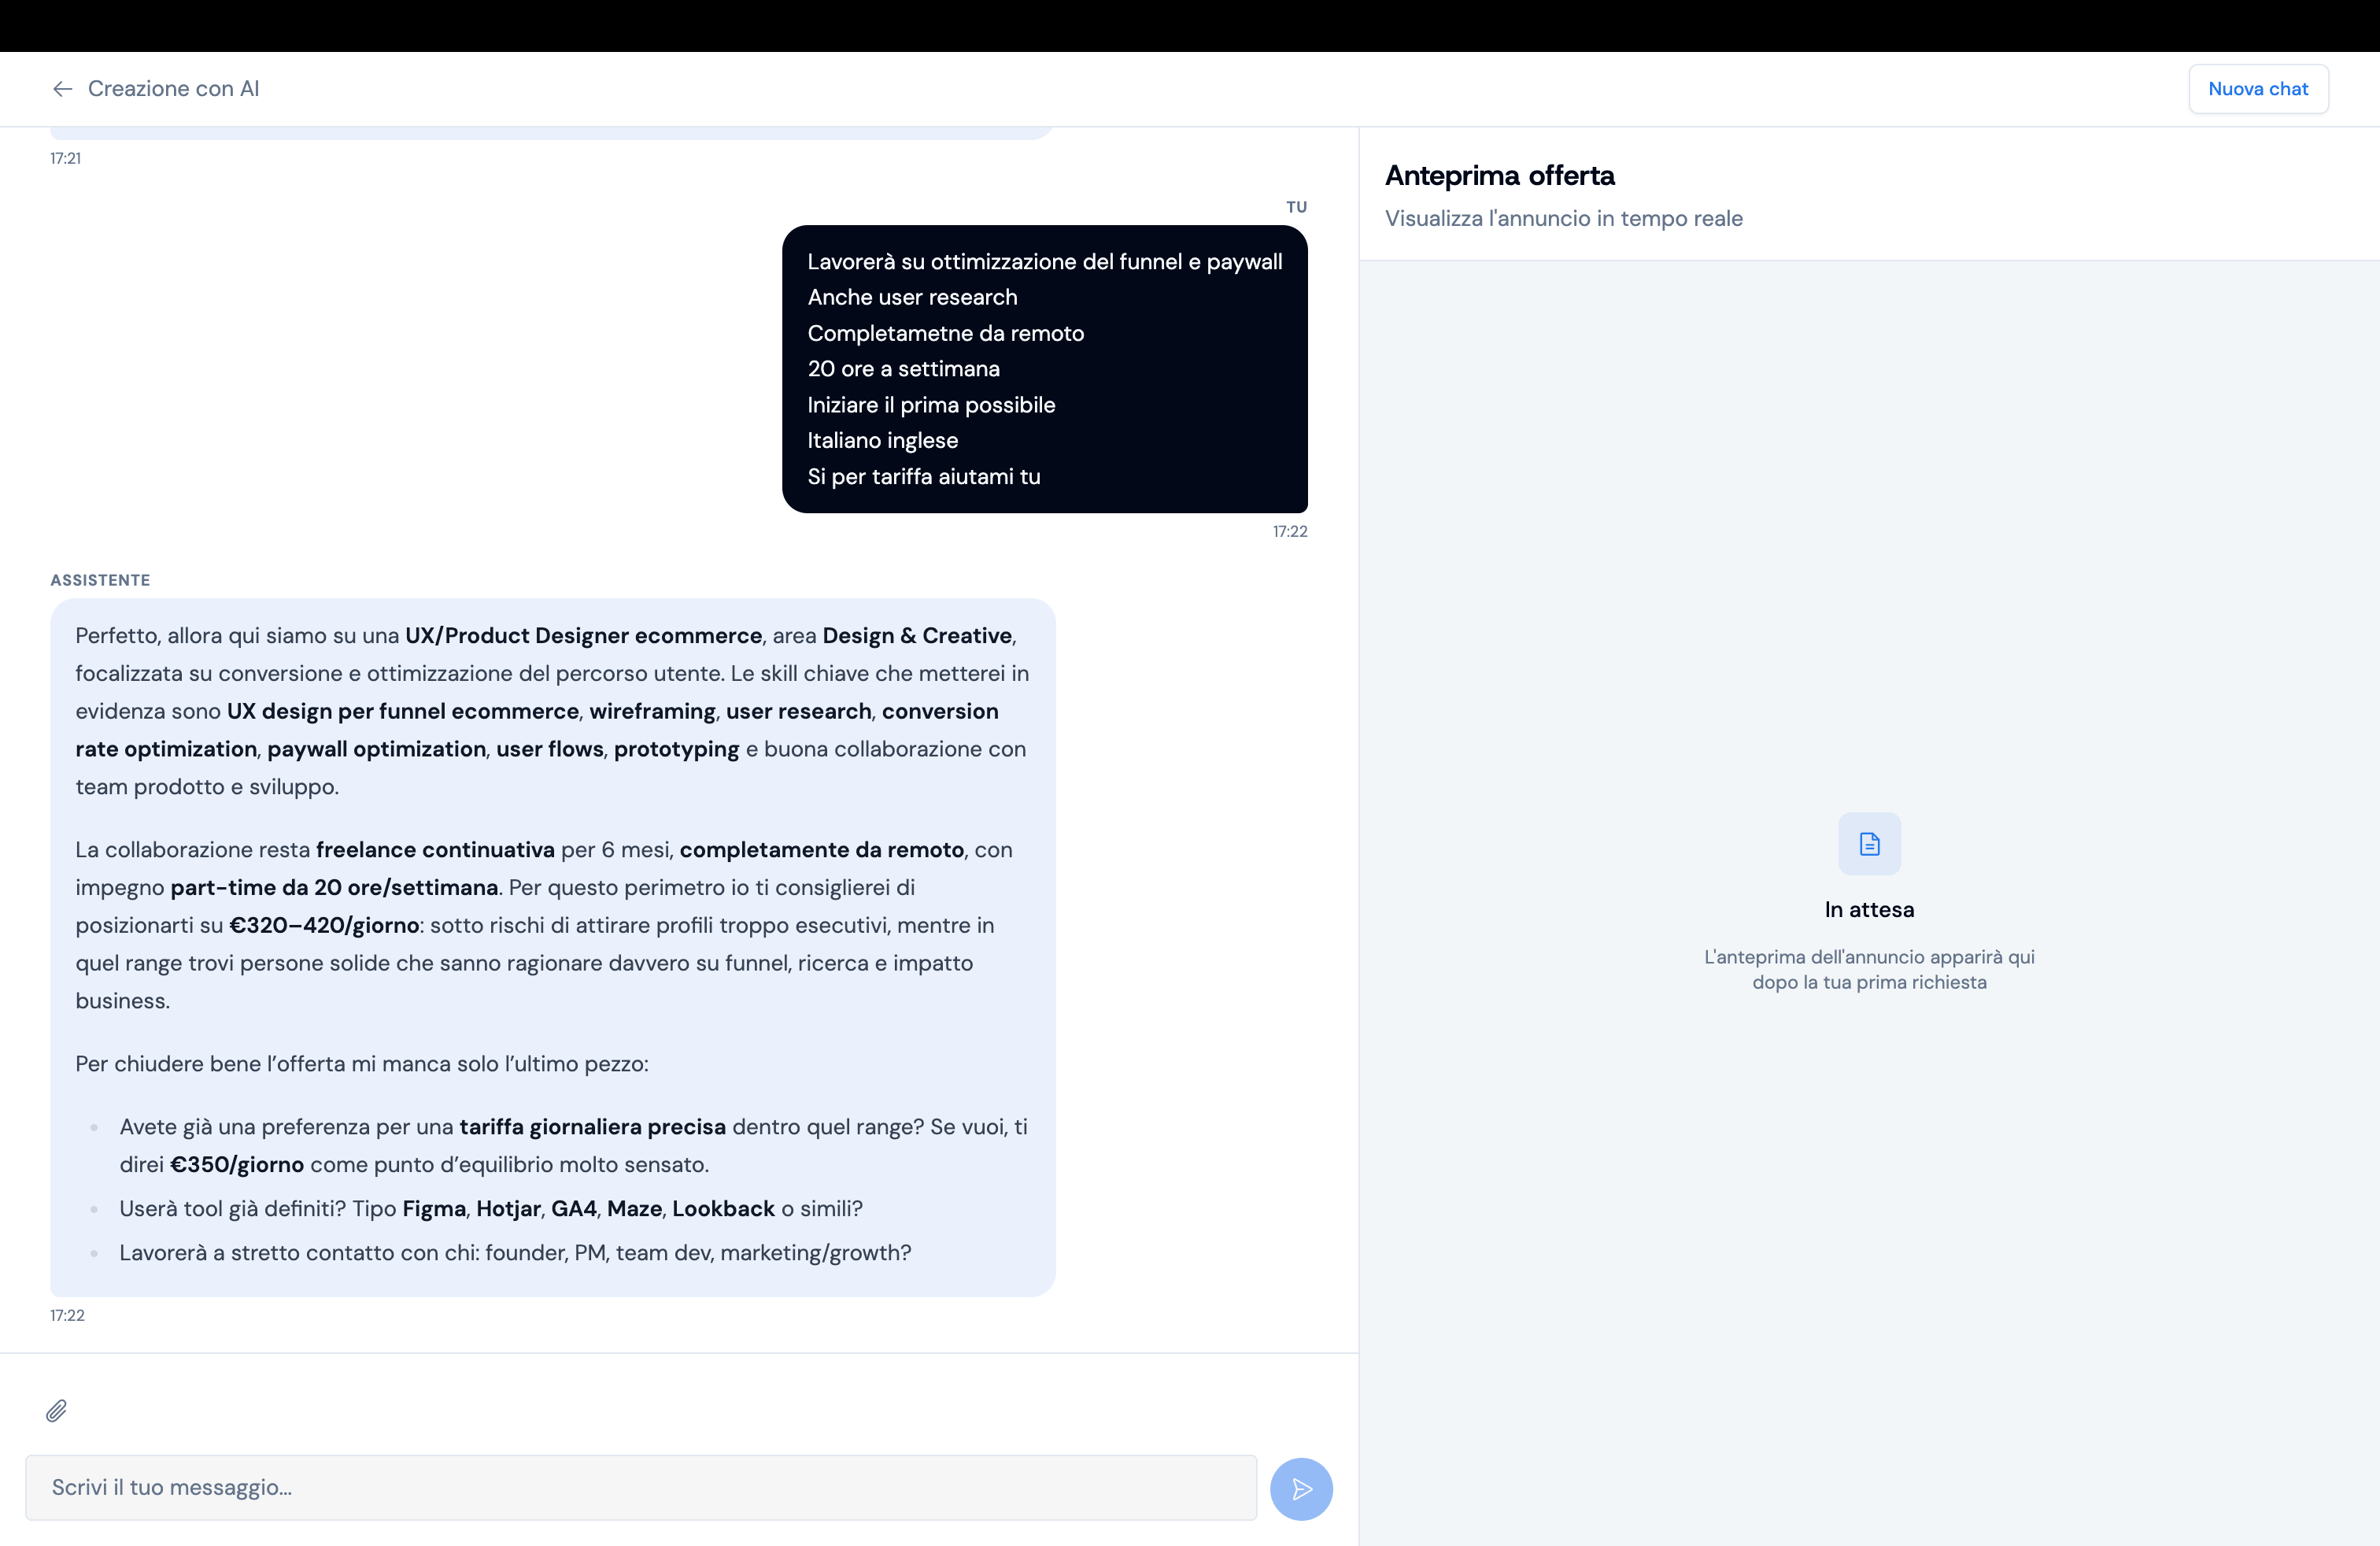
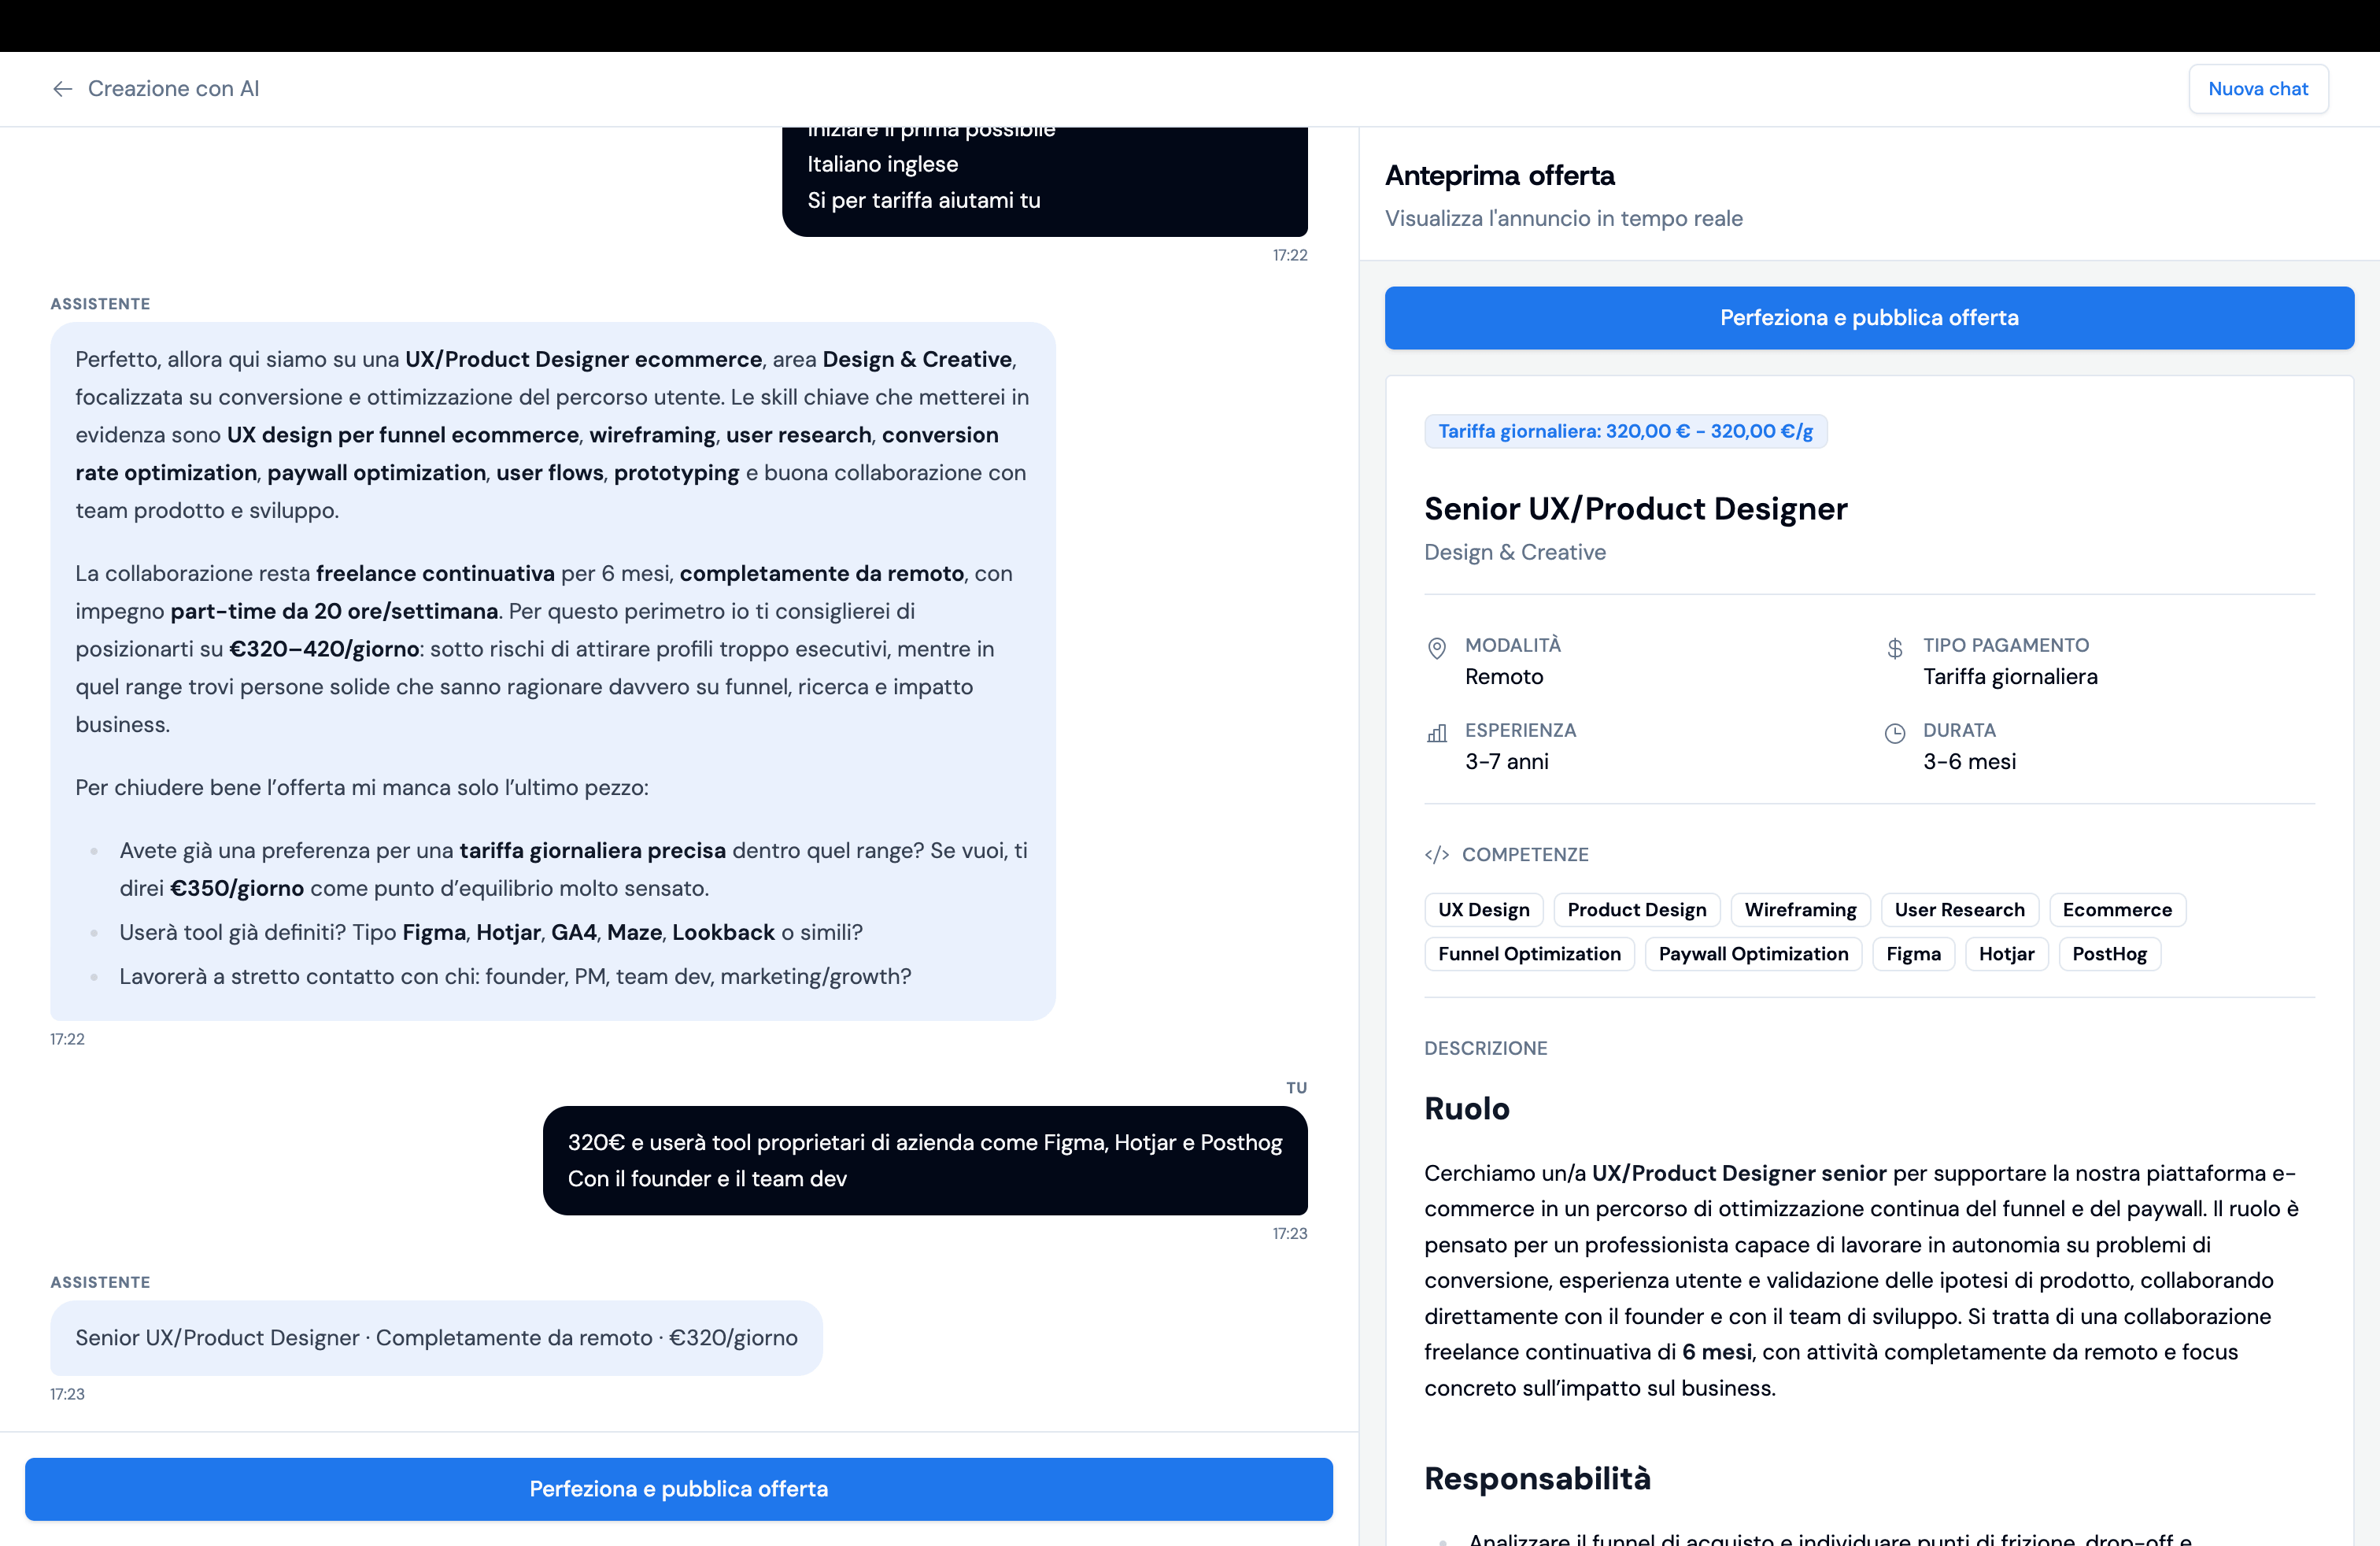
Una chat interattiva dove l'AI ti intervista, interpreta e legge PDF, immagini, TXT e ti accompagna nella creazione dell'offerta: propone la tariffa di mercato e in 3 domande l'annuncio completo e pronto da pubblicare.
Dopo aver ottimizzato il flusso di creazione dei profili riducendo il tempo di creazione < 37 secondi e migliorando l'accuratezza grazie alla sincronizzazione con LinkedIn, rimaneva un problema simile dall'altra parte del marketplace dove le aziende pubblicavano offerte passando da wizard a 5 step che non facilitavano la creazione di un annuncio completo e standardizzati
Chi ricerca un professionista non sempre è un recruiter o ha esperienza nella creazione di offerte, né ha una conoscenza approfondita del mercato. Il risultato erano offerte vaghe, con descrizioni di una riga e tariffe scollegate dal mercato; portando a poche candidature e soprattutto disallineate dal profilo desiderato.
Il flusso di creazione era un wizard classico: Progetto & Ruolo, Tariffa, Contratto, Link per il colloquio & anteprima pre pubblicazione. Tecnicamente impeccabile, praticamente inutile per chi non sa già cosa scrivere. Il form validava i campi, non la qualità.
Nessuna guida sul contenuto. Il wizard chiedeva titolo, categoria, tag e descrizione, ma non aiutava a scriverli né a fornire dati a supporto.
Tariffe senza riferimenti di mercato. E' una scelta che non paga dare per scontato che chiunque cerchi un freelance conosca le tariffe di mercato.
Descrizioni approssimative producono candidature disallineate. Nessuna garanzia di coerenza tra descrizione, responsabilità, aspettative con le competenze richieste e utili a realzzare il progetto.
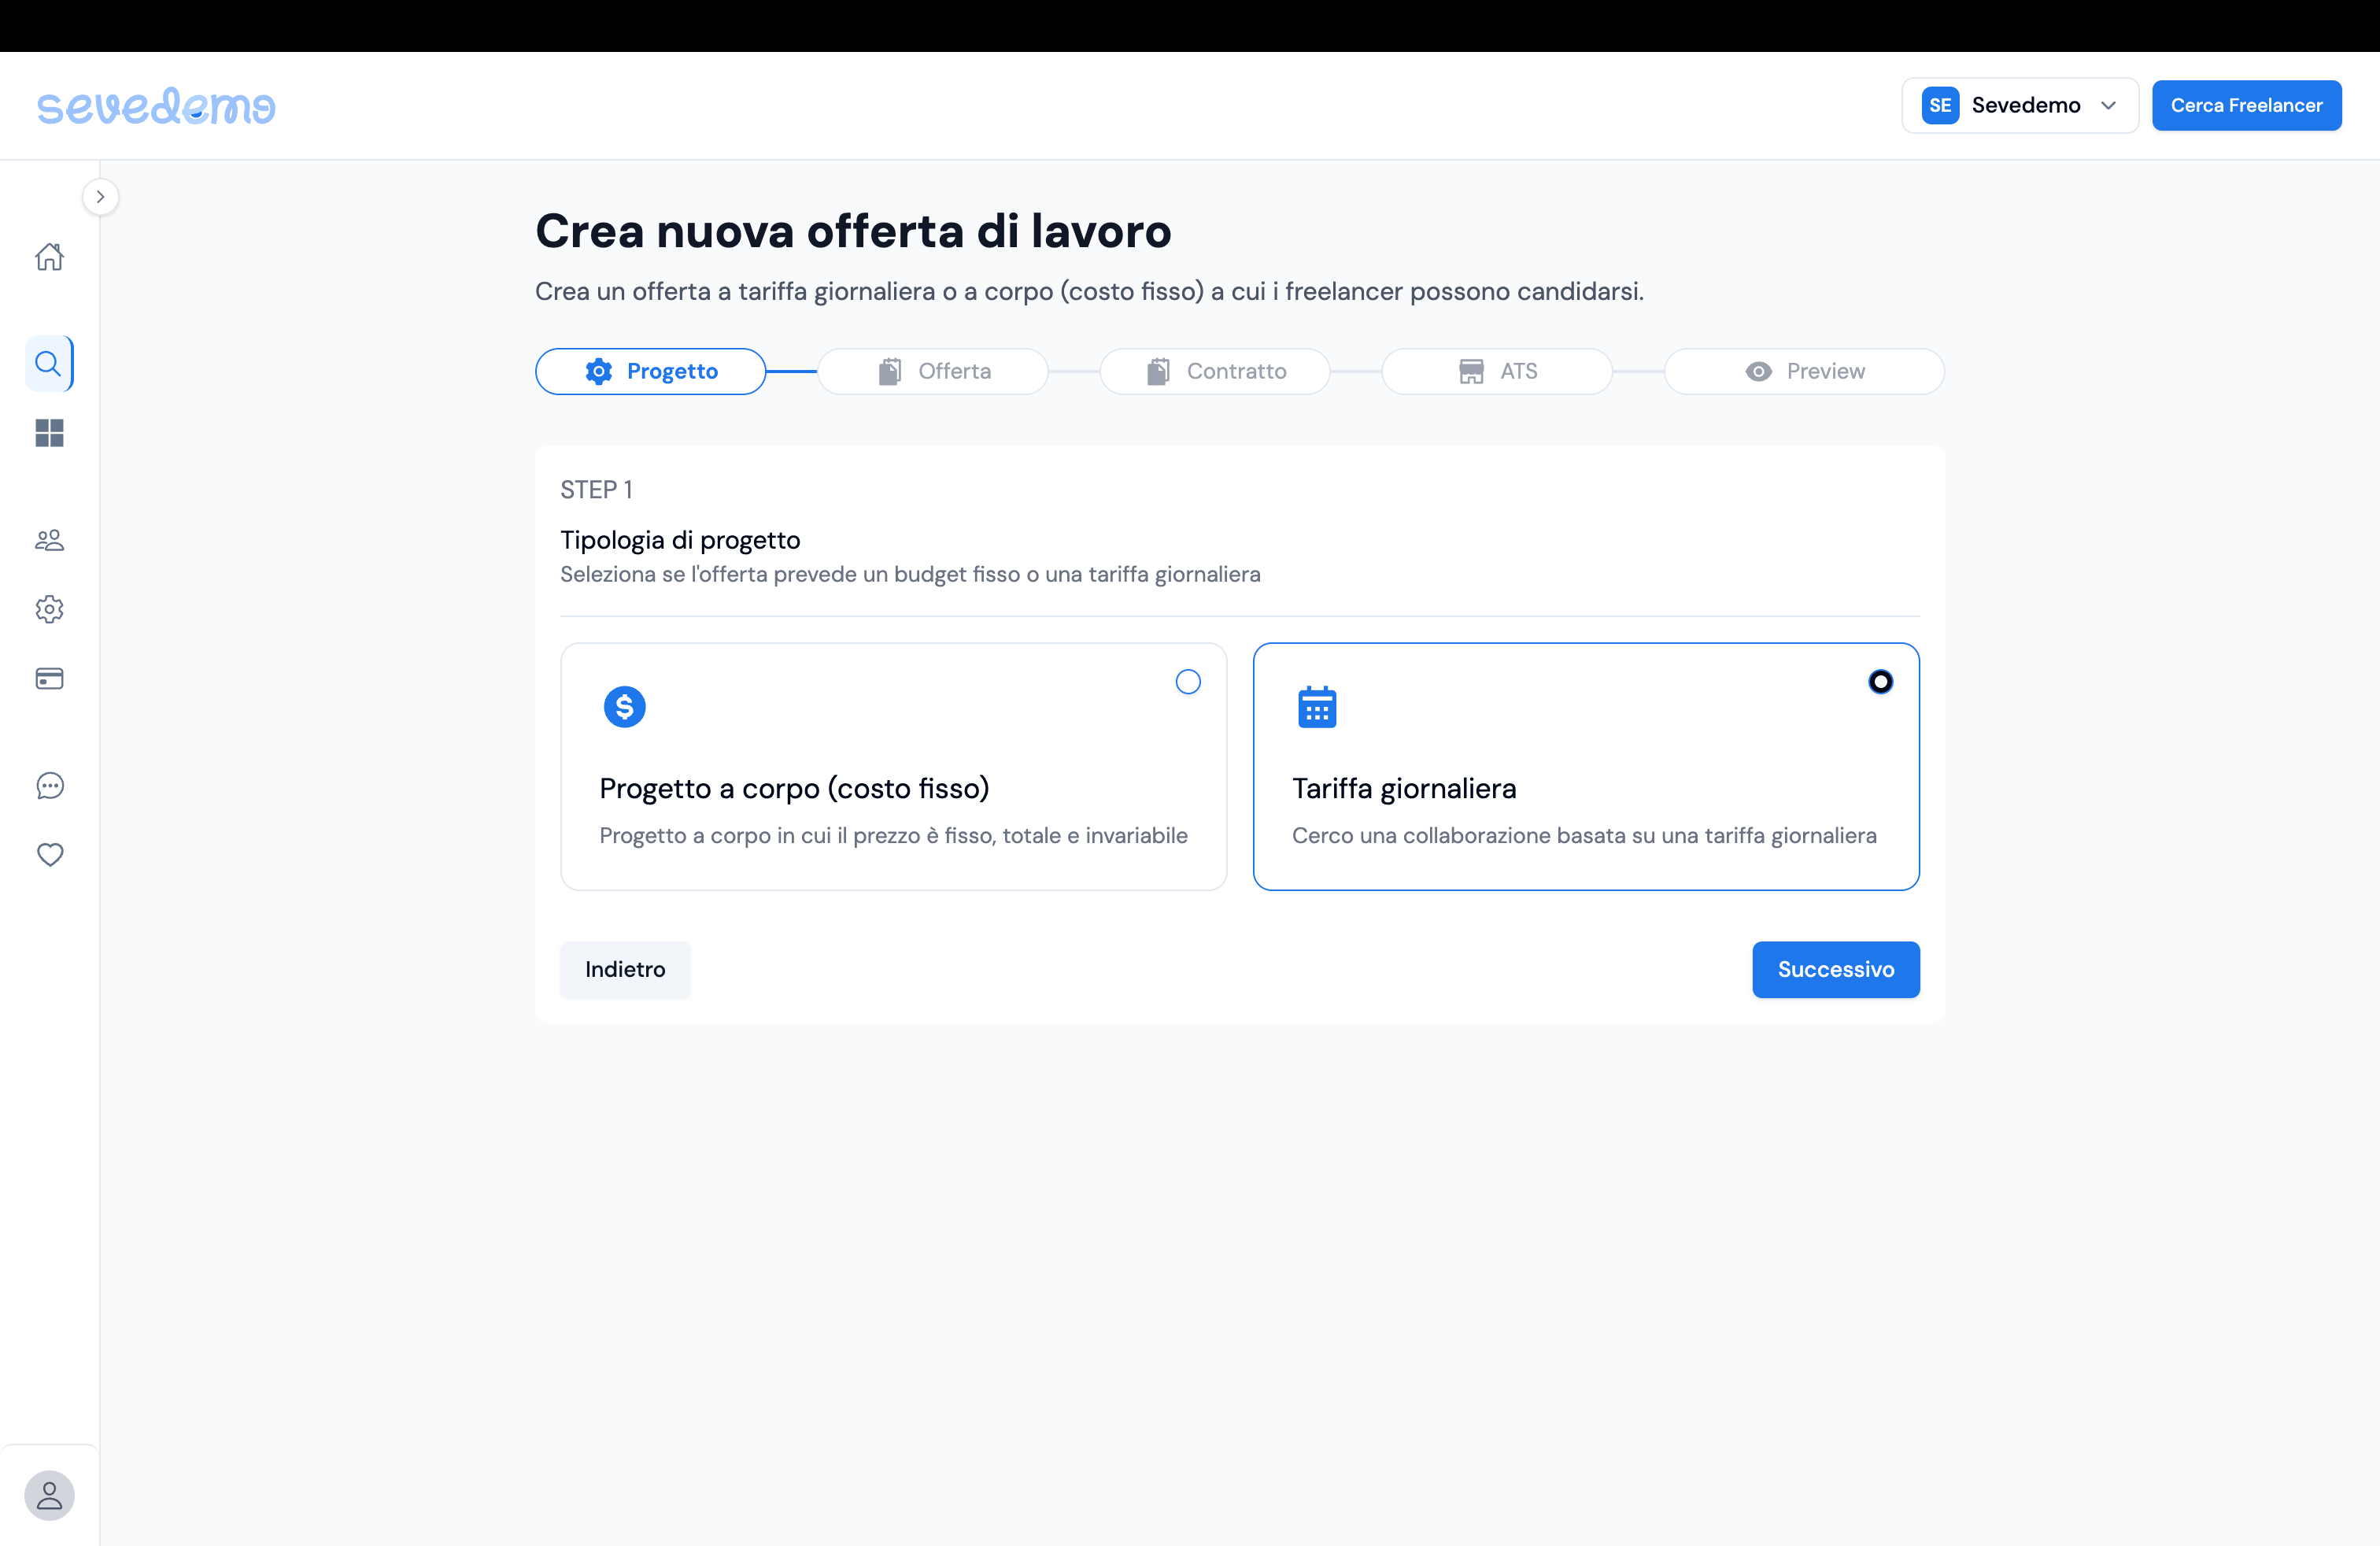
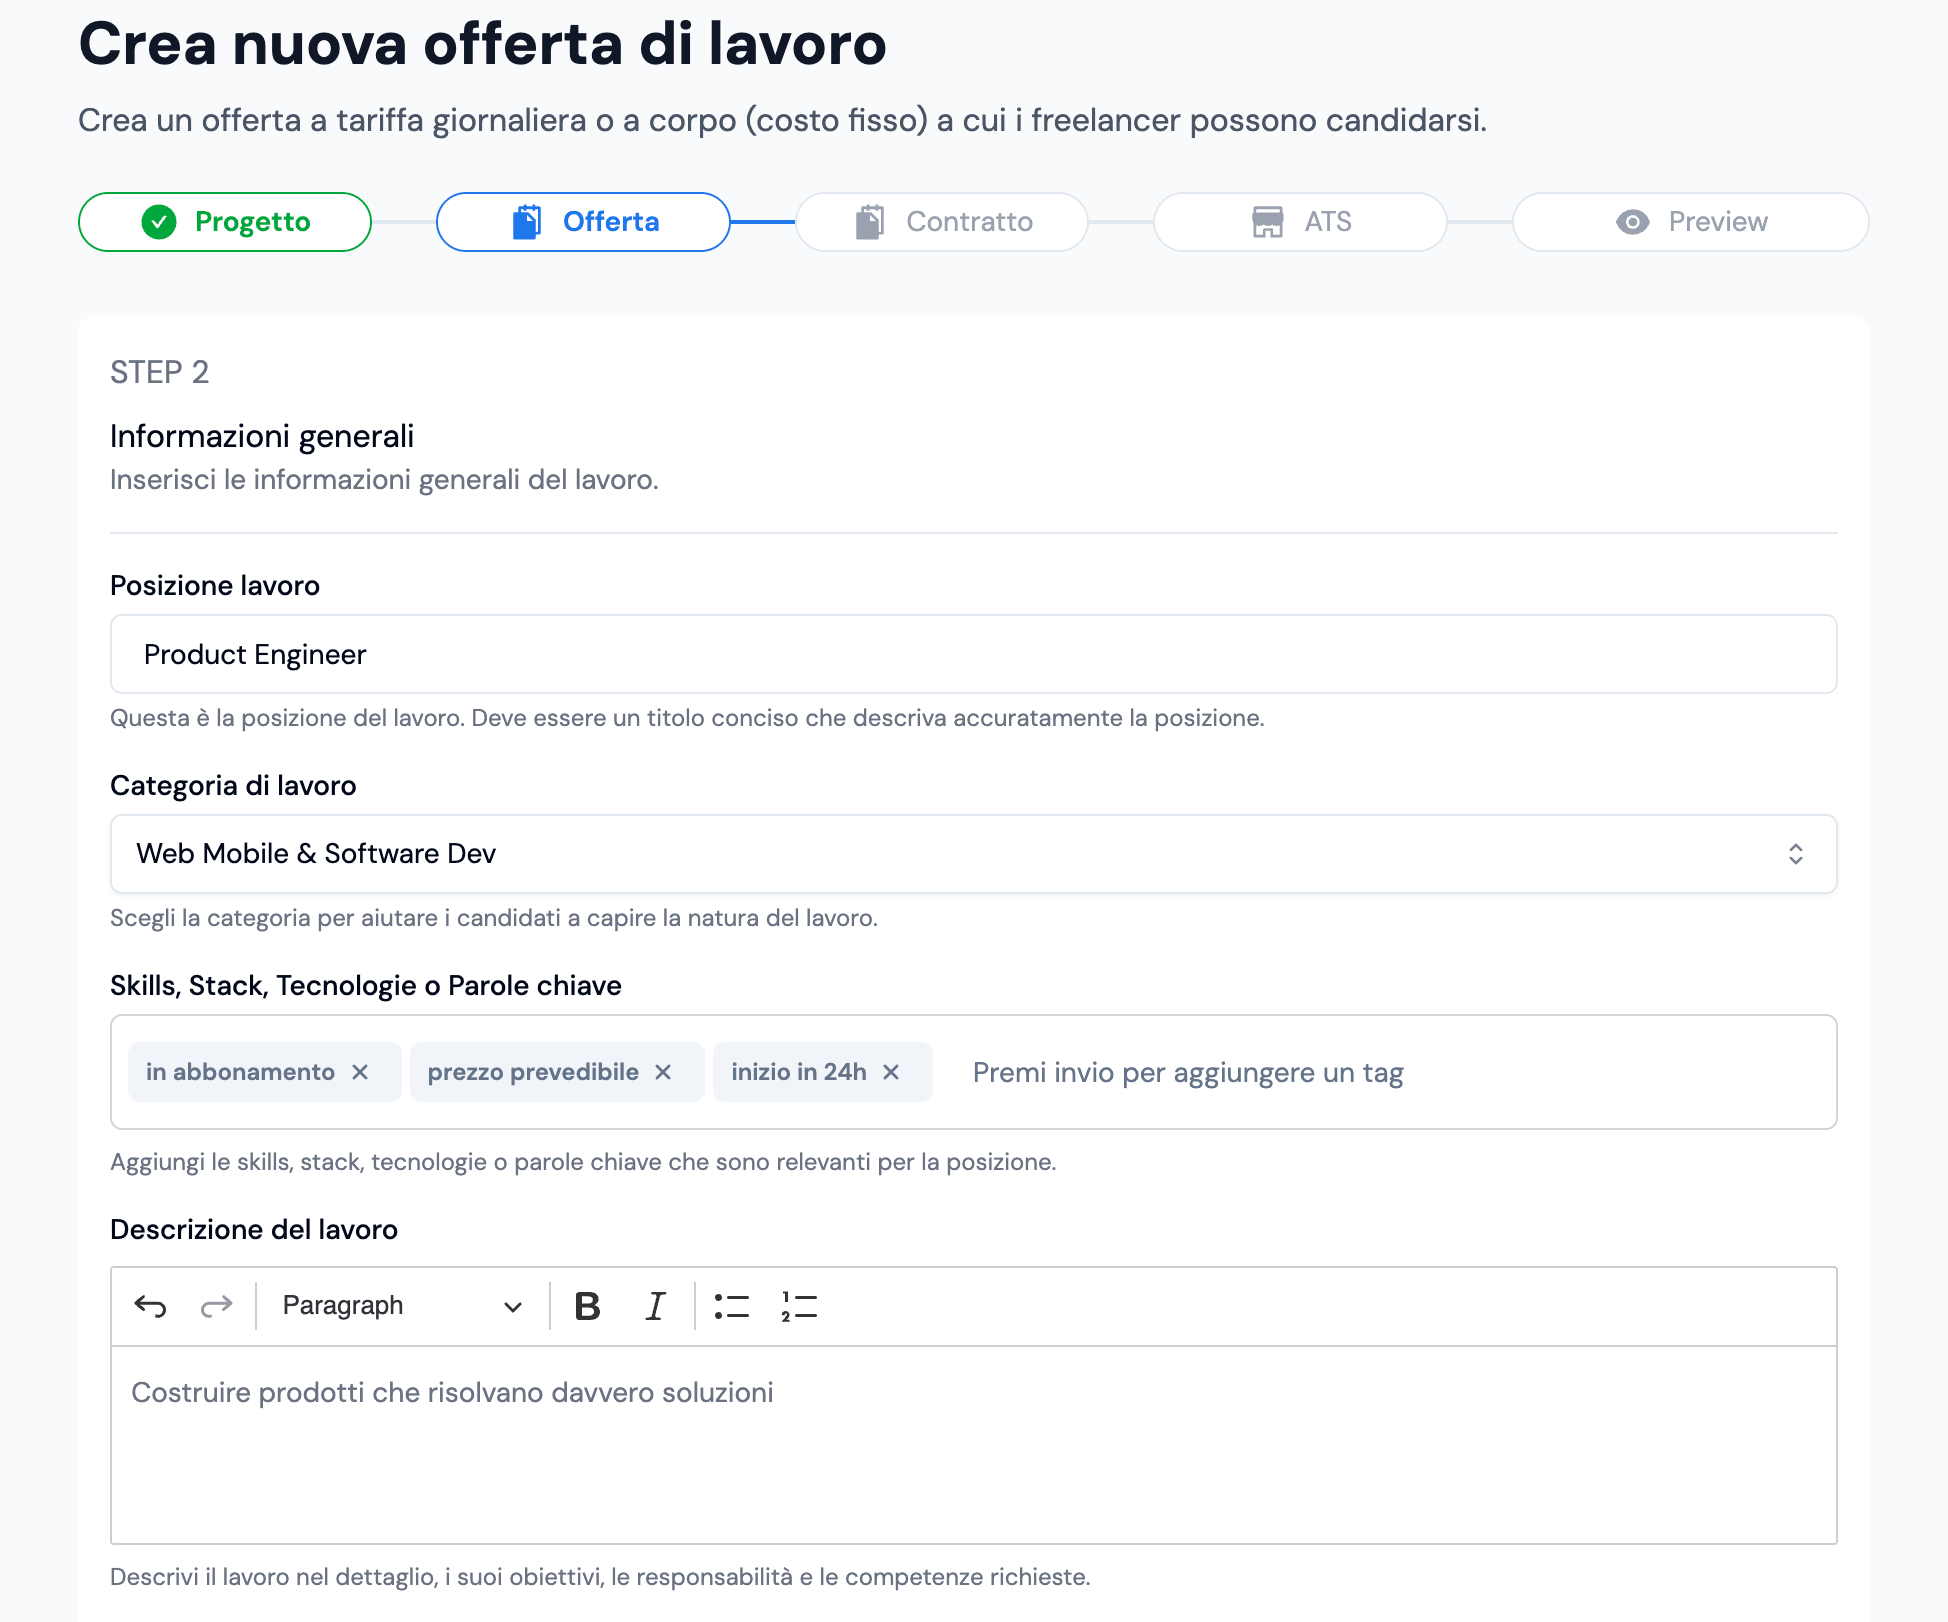
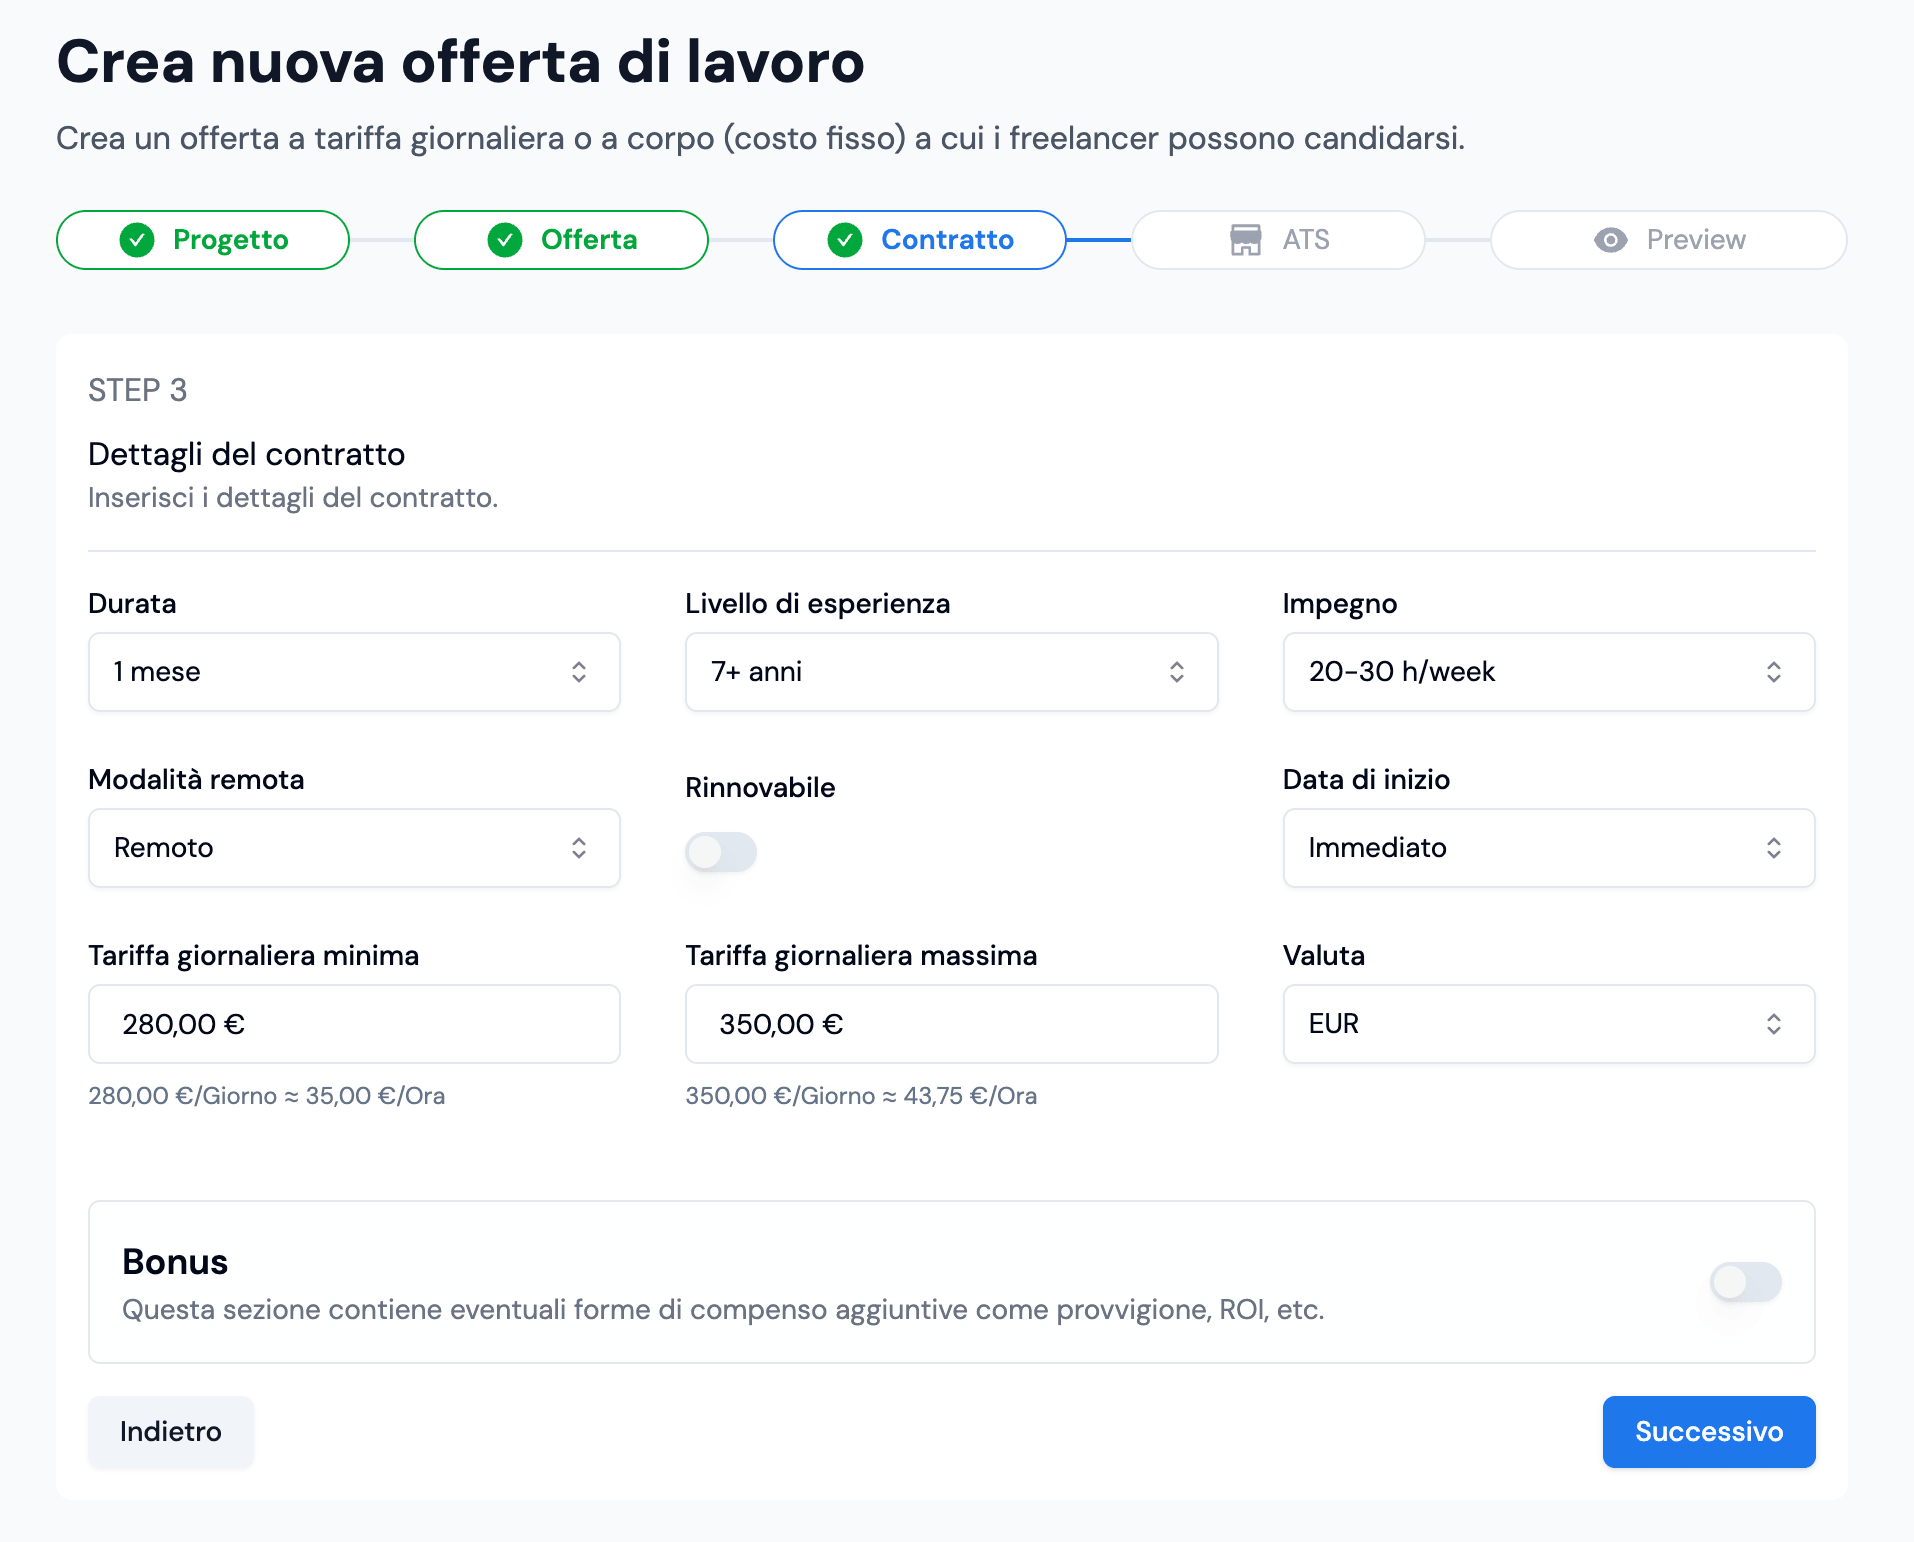
Un recruiter non ti dà un form da compilare ma fa le domande, legge documenti, immagini e curriculum e se qualcosa non è chiaro ti aiuta a risolvere il problema.
L'AI intervista come un recruiter. Deduce ed estrae titolo, categoria, seniority e competenze. La strategia è esplicita nel prompt: fornire una priva versione entro 3 scambi, poi recuperare informazioni mancanti ed infine suggerire la tariffa.
Supporta fino a 10 file: PDF, immagini e TXT. Curriculum, requisiti, descrizioni di progetto: che siano PDF o immagini si allegano direttamente in chat, vengono compressi, processati ed entrano nel contesto della conversazione.
Tariffe coerenti con il mercato. Le tariffe vengono confrontate con quelle dei freelance presenti in piattaforma. Nessun dati è casuale: l'AI propone un range di mercato coerente con il ruolo, la seniority e le competenze richieste.
Human in the loop. U secondo modello estrae dalla conversazione il payload strutturato dell'offerta e aggiorna l'anteprima accanto alla chat. Rendendo ogni passaggio revisionabile prima della pubblicazione.


L'interfaccia è una chat in Solid.js e sul BE un servizio Express costruito con Effect: errori tipizzati, retry con backoff esponenziale e ogni chiamata AI tracciata con il suo costo.
Due modelli, due lavori. Un modello si occupa di conversare con l'utente, il secondo riassume, estrae informazioni e indica che cosa manca per porre le domande corrette. L'estrazione del payload usa un modello mini con structured output: mai parsing fragile, mai campi inventati.
export const createChatStream = (
messages: ChatMessage[],
context: ChatContext
): Effect.Effect<AsyncIterable<ChatCompletionChunk>, AiServiceError> =>
Effect.tryPromise({
try: () =>
openai.chat.completions.create({
model: CHAT_MODEL, // la persona del recruiter vive nel system prompt
messages: [
{ role: "system", content: buildSystemPrompt(context) },
...messages,
],
stream: true,
stream_options: { include_usage: true },
}),
catch: (cause) => new AiServiceError({ cause }),
}); export const extractPayload = (
messages: ChatMessage[],
context: ChatContext,
usageContext?: AiUsageContext
): Effect.Effect<AiJobOfferPayload, AiServiceError> =>
createTrackedChatCompletion(
{
model: EXTRACTION_MODEL, // estrae, non conversa
response_format: {
type: "json_schema",
json_schema: {
name: "job_offer_payload",
strict: true,
schema: aiJobOfferPayloadJsonSchema,
},
},
messages: [
{ role: "system", content: buildExtractionSystemPrompt(context) },
...messages,
],
},
{ usageContext, callKind: AI_USAGE_CALL_KINDS.EXTRACTION }
).pipe(
Effect.mapError((cause) => new AiServiceError({ cause })),
Effect.map((res) => resolveRatePayload(parsePayload(res)))
); const resolveRatePayload = (raw: AiJobOfferPayload): AiJobOfferPayload => {
if (raw.payment_type === "fixed") {
return { ...raw, rate_min: null, rate_max: null, rate_unit: null };
}
validateJobOfferRate({
daily_rate_min: raw.rate_min ?? null,
daily_rate_max: raw.rate_max ?? null,
payment_type: "daily",
});
return { ...raw, payment_type: "daily", rate_unit: "daily" };
}; File allegati: compressione, parsing e storage temporaneo. Il tipo di file si decide dai magic bytes non dall'estensione e le immagini vengono compresse con Sharp a qualità decrescente fino a rientrare nel budget; i PDF diventano immagini pagina per pagina via Poppler. Tutto passa da uno storage temporaneo su GCS e viene eliminato alla fine o all'interruzione del processo.
export function validateAndAssemble(message: string, files: StoredFile[]) {
return Effect.gen(function* () {
const processed = yield* processFiles(files); // Sharp per le immagini, Poppler per i PDF
const blocks = assembleContentBlocks(message, processed);
yield* validateImageBlocksBeforeSend(blocks); // niente oltre soglia arriva al modello
return blocks;
});
} export function detectFileType(buffer: Buffer): DetectedFileType | null {
if (buffer[0] === 0x25 && buffer[1] === 0x50 && buffer[2] === 0x44 && buffer[3] === 0x46) {
return { category: "pdf", mimeType: "application/pdf" }; // %PDF
}
if (buffer[0] === 0x89 && buffer[1] === 0x50 && buffer[2] === 0x4e && buffer[3] === 0x47) {
return { category: "image", mimeType: "image/png" };
}
if (buffer[0] === 0xff && buffer[1] === 0xd8 && buffer[2] === 0xff) {
return { category: "image", mimeType: "image/jpeg" };
}
return null; // l'estensione dichiarata non conta niente
} const JPEG_QUALITIES = [80, 60, 40, 20] as const;
for (const quality of JPEG_QUALITIES) {
const compressed = await sharp(buffer)
.resize(width, height, { fit: "inside", withoutEnlargement: true })
.jpeg({ quality })
.toBuffer();
if (compressed.length <= IMAGE_TARGET_RAW_SIZE) {
return buildImageBlock(compressed, "jpeg");
}
} export function storeFile(userId: string, file: UploadedFile) {
return Effect.tryPromise({
try: async () => {
const fileId = crypto.randomUUID();
await bucket.file(buildGcsPath(userId, fileId)).save(file.buffer, {
metadata: { contentType: file.detectedType.mimeType /* ... */ },
});
return fileId; // al client torna solo l'id, mai il file
},
catch: (cause) => new GcsStoreError({ operation: "upload", cause }),
});
}
export const downloadFiles = (fileIds: string[], userId: string) =>
Effect.all(fileIds.map((id) => downloadFile(id, userId)), { concurrency: 3 }); Auto-compaction del contesto. Ogni conversazione ha un budget di token stimato. Superata la soglia, la storia si comprime: restano i primi messaggi e gli ultimi, con un riassunto al posto del resto, rimuovendo gli allegati vecchi. Il context bloat è il modo più rapido per far degradare qualità e costi.
export const TOKEN_BUDGET = 8000;
export const estimateTokens = (messages: ChatMessage[]): number =>
messages.reduce((acc, m) => {
if (typeof m.content === "string") {
return acc + Math.ceil(m.content.length / 4);
}
return acc + m.content.reduce(
(sum, part) =>
part.type === "text" ? sum + Math.ceil(part.text.length / 4) : sum + 250,
0
);
}, 0); const MAX_MESSAGES_FOR_API = 10;
const ALWAYS_KEEP_FIRST = 2;
export const trimMessagesForChat = (messages: ChatMessage[]): ChatMessage[] => {
if (messages.length <= MAX_MESSAGES_FOR_API) return messages;
const first = messages.slice(0, ALWAYS_KEEP_FIRST);
const recent = messages.slice(-(MAX_MESSAGES_FOR_API - ALWAYS_KEEP_FIRST));
const bridge: ChatMessage = {
role: "user",
content: "[Messaggi precedenti omessi per brevità. Le informazioni raccolte finora sono già riflesse nei messaggi successivi.]",
};
return [...first, bridge, ...recent];
}; export const stripOldFileContent = (messages: ChatMessage[]): ChatMessage[] =>
messages.map((msg, i) => {
if (i === messages.length - 1) return msg; // l'ultimo tiene i suoi allegati
if (Array.isArray(msg.content)) {
const textPart = msg.content.find((p) => p.type === "text");
return { ...msg, content: textPart?.text ?? "" };
}
return msg;
}); Guardrail espliciti. Le richieste fuori tema vengono reindirizzate con una escalation a tre livelli, le istruzioni nascoste nei file allegati vengono ignorate per design e hard limit su messaggi e dimensioni mitigano file enormi e costi eccessivi.
import { Data } from "effect";
export class AiServiceError extends Data.TaggedError("AiServiceError")<{
cause?: unknown;
}> {}
export class TokenBudgetExceededError extends Data.TaggedError(
"TokenBudgetExceededError"
)<{ cause?: unknown }> {}
export class DbError extends Data.TaggedError("DbError")<{ cause?: unknown }> {} export const aiJobOfferChatRequestSchema = z.object({
messages: z.array(chatMessageSchema).min(1).max(50),
file_ids: z.array(z.string().uuid()).max(10).optional().default([]),
visibility: z.enum(visibilityEnum),
company_id: z.string(),
}); Effect.tryPromise({
try: () => openai.chat.completions.create(params),
catch: (cause) => new AiServiceError({ cause }),
}).pipe(
// due tentativi extra, 500ms poi 1s: un blip di rete non diventa un errore utente
Effect.retry(
Schedule.exponential("500 millis").pipe(Schedule.intersect(Schedule.recurs(2)))
)
); Ogni modello è dotato di prompt univoco e si appoggia su tools condivisi in altre parti del prodotto. Per evitare regressioni, ogni modifica al prompt o ai tool passa da una pipeline di evaluation che genera 30 scenari diversi li itera ed un Model Grader li valuta, confronta con il valore precedente e se è diminuito oltre la soglia di passaggio blocca il rilascio. Tutto automatico, tutto in CI/CD.
// un LLM genera scenari diversi tra loro: personas, edge case, lingue
const scenarios = yield* evaluator.generateDataset({
taskDescription: JOB_OFFER_TASK,
totalScenarios: 30,
generationModel: GENERATION_MODEL,
}); const results = yield* Effect.all(
scenarios.map((scenario) =>
Effect.gen(function* () {
const input = extractInput(scenario);
const output = yield* runPromptFn(input);
const grade = yield* grader.grade(input, output, scenario);
return { scenario, input, output, grade };
})
),
{ concurrency: 3 }
); const passThreshold = options.passThreshold ?? 7; // sotto il 7 non si passa
const passRate =
(scores.filter((s) => s >= passThreshold).length / scores.length) * 100;
// i criteri bloccanti vincono sullo score: se violati, il run è rosso
const mandatoryCriteria = grader.getMandatoryCriteria();
const mandatoryViolationCount = results.filter((r) =>
r.grade.violations.some((v) => mandatoryCriteria.includes(v))
).length; Tutto diventa un'immagine: sembra controintuitivo ma abbiamo scelto di convertire file e PDF in immagini e farle passare attraverso una flusso di compressione incrementale. In questo modo il modello non deve fare parsing di PDF o DOCX, ma legge le immagini come se fossero screenshot e non perde mai il contesto della conversazione.
Parliamone: 30 minuti per capire se un'integrazione abbia senso nel tuo caso.
Prenota una call di 30 min Altri casi studio